
Objectifs
- Construire un moteur RAG minimaliste et léger en utilisant un serveur Ollama.
- Comprendre les briques fondamentales : le scan de fichiers, l’indexation vectorielle incrémentale, la recherche top-k dynamique, l’ingénierie de prompt basée sur des personas et le streaming des réponses LLM.
Introduction
Mettre en place une base de connaissances personnalisée (RAG) ne nécessite pas de frameworks d’orchestration complexes ni d’infrastructures cloud lourdes. Avec un codebase Python propre, LanceDB (une base de données vectorielle embarquée stockée sur disque) et Ollama s’exécutant en local, vous pouvez déployer en quelques minutes un moteur de connaissances souverain et axé sur la confidentialité.
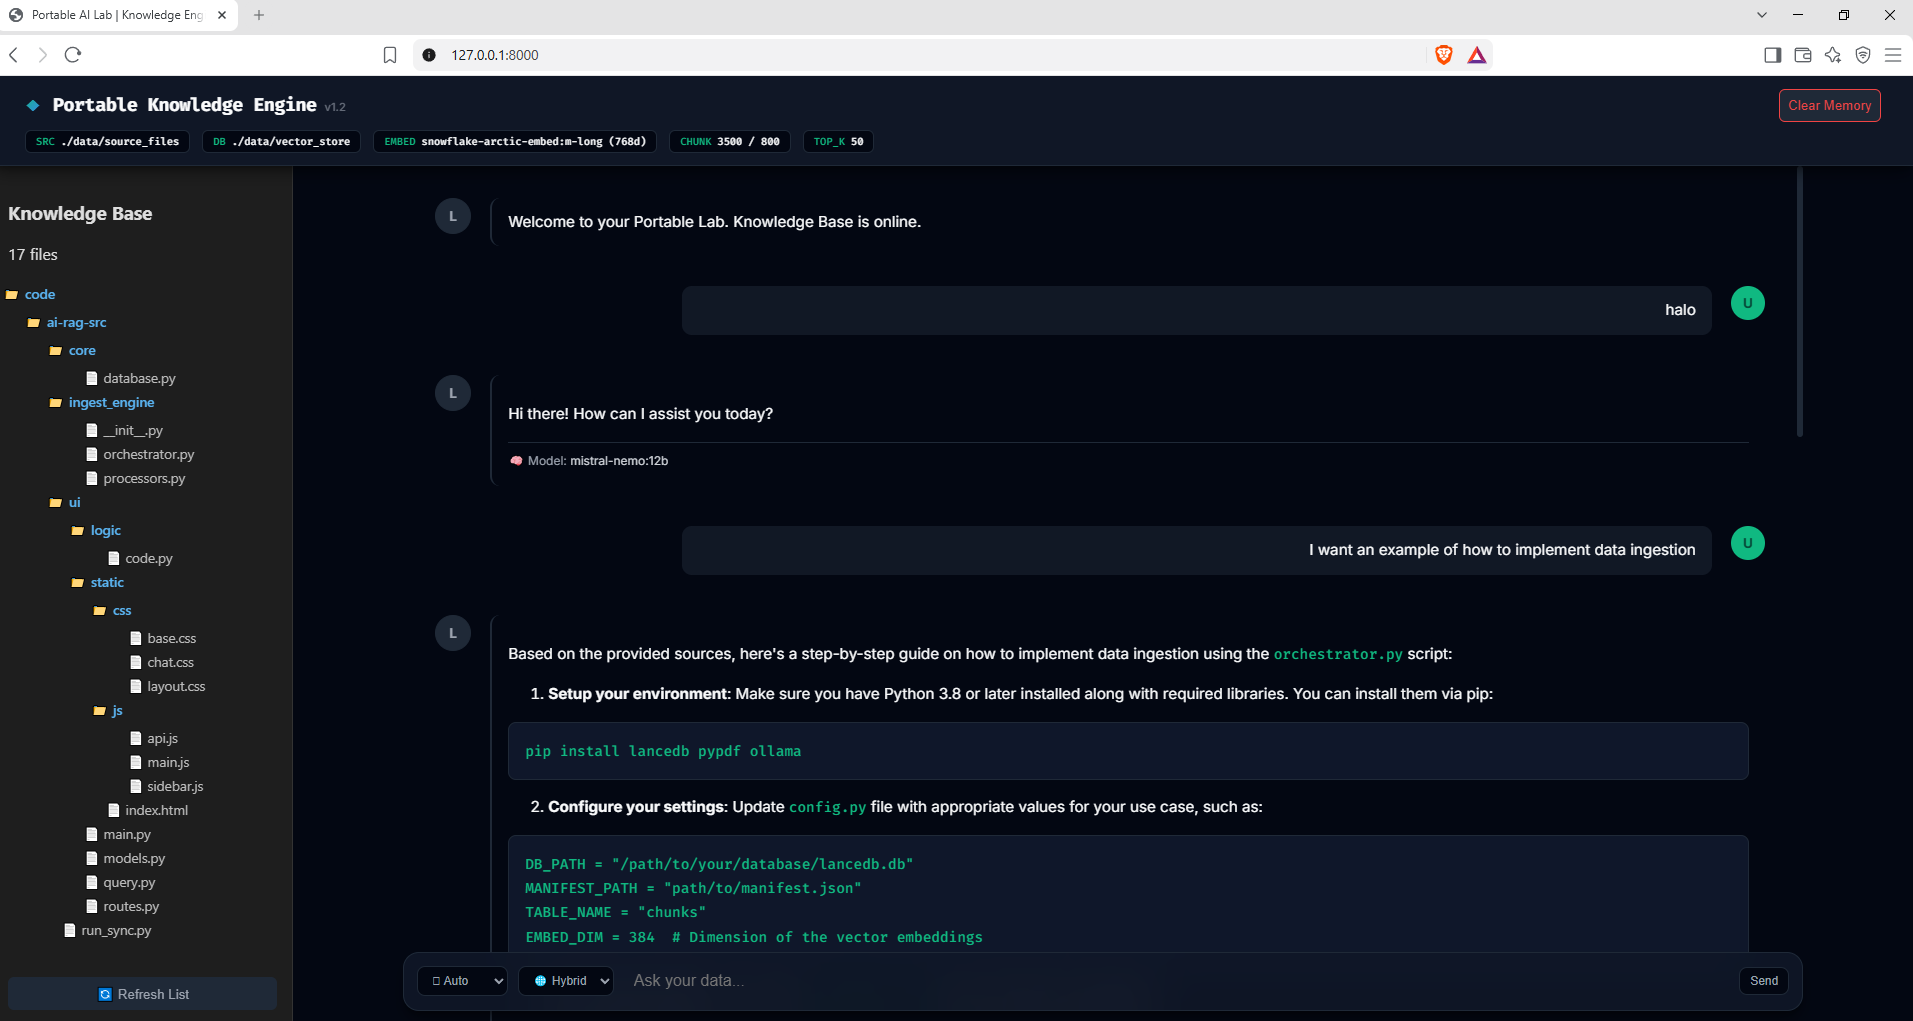
L’interface web de ce projet est conçue pour offrir un contrôle en temps réel sur l’état du moteur :
- Vider la mémoire cache : Une action directe (
POST /reset) qui purge le store vectoriel LanceDB et supprime le fichiermanifest.json. Cela vous permet de repartir d’une page blanche si vous devez modifier drastiquement les paramètres de chunking ou nettoyer un état corrompu. - Synchronisation à la demande : Vous pouvez exécuter la synchronisation d’ingestion manuellement à tout moment pour traiter instantanément les ajouts, suppressions ou modifications de fichiers, garantissant ainsi que la base de données reste parfaitement alignée avec votre espace de travail local.
- Vue arborescente (sidebar) : Un inventaire visuel (
GET /indexed-files) dresse la carte exacte des fichiers sources ingérés qui servent activement de contexte au modèle.
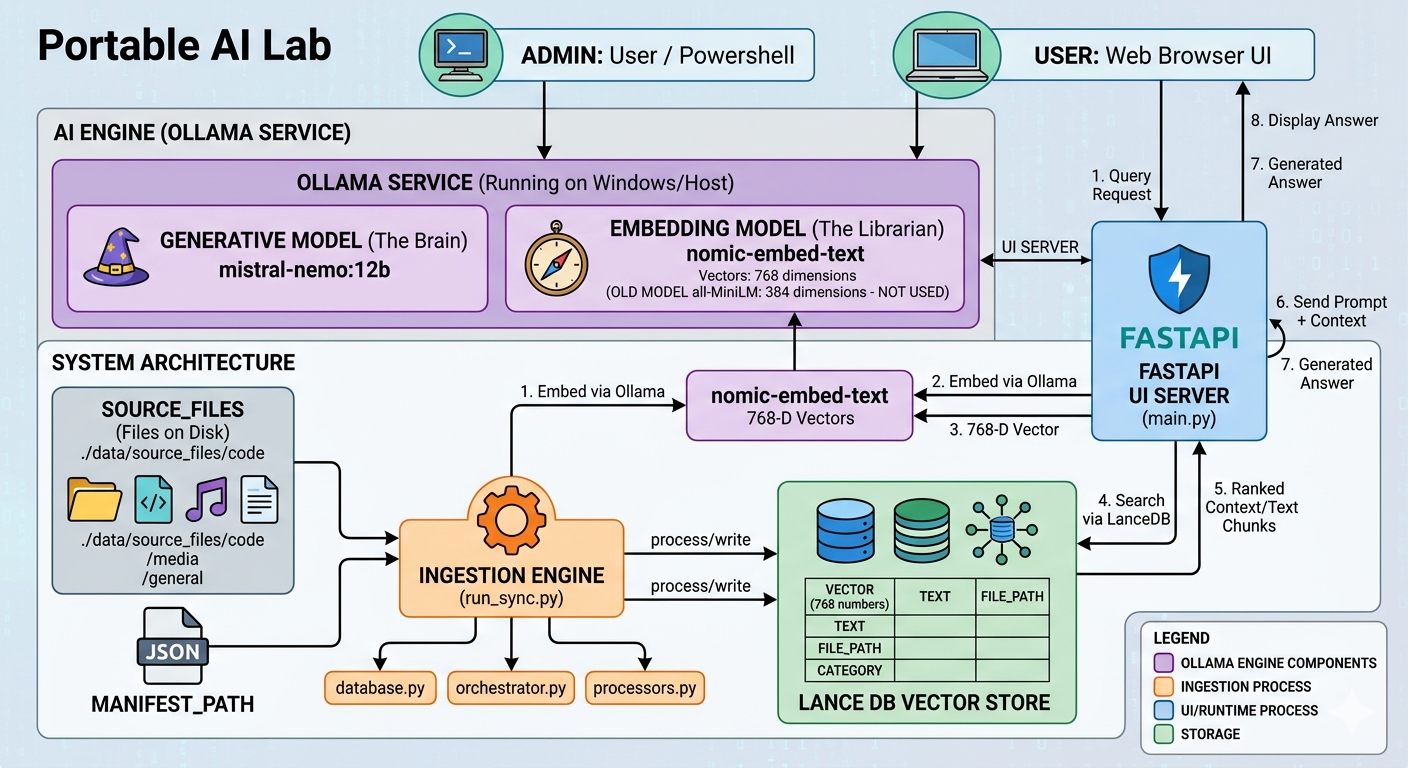
Voici un aperçu de l’architecture système :
⚠️ Important : Avertissement Matériel & Mémoire
Configuration matérielle minimale : La configuration par défaut fournie dans ce projet est optimisée pour des machines disposant d’au moins 16 Go de VRAM/RAM.
L’exécution simultanée de larges fenêtres de contexte, d’un nombre élevé de résultats récupérés et de modèles d’embedding peut rapidement consommer la mémoire de votre système.
Si vous travaillez sur une machine équipée de 8 Go ou 12 Go de RAM/VRAM, mettez à jour vos paramètres de configuration pour éviter de figer votre système :
- Diminuez
CHUNK_SIZEetCHUNK_OVERLAP. - Abaissez les seuils de récupération (retrieval thresholds).
- Utilisez des modèles Ollama légers pour les embeddings et la génération.
Code Source
Code source du service IA portable :
- Source du moteur de base de connaissances : https://github.com/a-naitslimane/anaitslimane.article.portable-ai-rag
Installation
Suivez ces étapes pour installer et configurer le moteur sur votre machine.
Étape 1 : Installer et lancer Ollama
Ollama sert de serveur d’inférence local pour les embeddings vectoriels et la génération LLM sur macOS, Linux et Windows.
-
Téléchargement & Installation :
- macOS / Windows : Téléchargez l’installateur depuis ollama.com/download .
- Linux : Exécutez le script d’installation officiel :
curl -fsSL https://ollama.com/install.sh | sh
-
Démarrer le moteur Ollama :
- Sur macOS / Windows, le lancement de l’application installée démarre automatiquement le service dans votre zone de notification.
- Sur Linux, démarrez le démon manuellement :
ollama serve
(Note : Le téléchargement et la configuration des modèles sont gérés dynamiquement pendant l’exécution, aucune commande manual pull n’est donc requise.)
Étape 2 : Configurer l’environnement Python et installer les dépendances
Clonez le dépôt, créez un environnement virtuel et installez les dépendances :
Sur Windows (PowerShell) :
python -m venv venv
.\venv\Scripts\Activate.ps1
pip install -r requirements.txt
Sur Linux / macOS :
python3 -m venv venv
source venv/bin/activate
pip install -r requirements.txt
Étape 3 : Ajouter les documents sources
Copiez le code source de vos projets, votre documentation ou vos documents de référence dans ./data/source_files/.
Étape 4 : Synchroniser la base vectorielle et démarrer le serveur
-
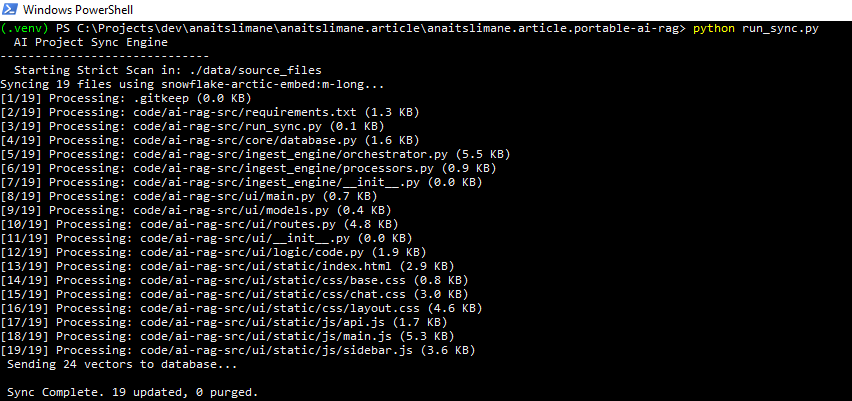
Exécuter le pipeline d’ingestion :
python run_sync.pyVoici la console d’ingestion en action :
-
Lancer le serveur API & UI :
uvicorn ui.main:app --reload
Ouvrez http://localhost:8000 dans votre navigateur pour interagir avec votre base de connaissances.
Voici l’interface en action :
Détails d’implémentation (Architecture de la base de code)
Ce moteur de connaissances spécifique implémente le pattern RAG de manière entièrement locale, en coordonnant le flux à travers des modules Python ciblés :
1. Le pipeline d’ingestion
- Découverte & Filtrage (
scanner.py&orchestrator.py) : Le système parcourt de manière récursive le répertoire source. Il ignore intelligemment les dossiers commenode_moduleset filtre les fichiers lock, le code minifié ou les binaires volumineux. Un fichieringestion_manifest.jsonsuit les horodatages de modification des fichiers (mtime) afin que les synchronisations ultérieures soient incrémentales—ne traitant que les fichiers nouveaux ou modifiés. - Parsing & Chunking (
processors.py&chunker.py) : Les fichiers pris en charge (PDF, Markdown, code brut) sont extraits sous forme de texte brut. Le texte est découpé en fenêtres chevauchantes (overlapping windows) pour garantir qu’aucun contexte ne soit perdu aux frontières des segments. - Embedding & Stockage (
embedder.py,vectors.py,database.py) : Les chunks sont envoyés à Ollama pour générer les embeddings. Les vecteurs subissent une normalisation L2 pour garantir des calculs de distance précis avant d’être insérés/mis à jour (upsert) dans LanceDB via des opérations par lots.
2. Le pipeline de requête (query.py & routes.py)
- Classification d’intention : Avant d’interroger la base de données, le prompt est évalué par Ollama via un classificateur au format JSON afin de détecter les intentions conversationnelles (ex: “bonjour”, “merci”). Si une telle intention est détectée, la recherche vectorielle est contournée pour économiser les ressources.
- Extension dynamique de la recherche (
code.py) : Si la requête implique une analyse structurelle (ex: demander une classe entière ou une architecture), le système augmente dynamiquement les limites de récupération pour capturer un contexte plus large. - Récupération normalisée & Filtrage par distance : Les embeddings de la requête sont normalisés et comparés à LanceDB. Un seuil de distance strict garantit que seuls les chunks hautement pertinents sont récupérés, évitant ainsi les “hallucinations” causées par l’injection de textes non pertinents dans le modèle.
- Systèmes de personas & Prompts (
personas.py,prompts.py) : Le contexte récupéré est intégré dans des prompts système spécialisés selon la persona sélectionnée (code,docouauto). Le prompt ordonne explicitement au LLM de fonder sa réponse exclusivement sur le contexte fourni. - Réponse en streaming : La génération finale est transmise à l’interface utilisateur en temps réel sous forme de flux (streaming) grâce aux Server-Sent Events (SSE) via FastAPI.
3. Ajustement de la qualité et de la pertinence (Paramètres de configuration)
Chaque aspect de la qualité de récupération peut être contrôlé via config.py et les paramètres de l’IHM :
CHUNK_SIZE&CHUNK_OVERLAP: Des chunks plus grands fournissent plus de contexte au LLM mais diluent les détails spécifiques et consomment rapidement la fenêtre de contexte. Des chunks plus petits et chevauchants assurent une récupération précise mais risquent de couper des blocs de code au milieu d’une fonction.TOP_K(Rappel / Recall) : Détermine le nombre de chunks récupérés initialement. Des valeurs plus élevées capturent plus d’informations mais augmentent l’utilisation de la mémoire et le temps de traitement.DISTANCE_THRESHOLD(Précision) : Définit la distance vectorielle maximale autorisée. Diminuer cette valeur agit comme un filtre strict—seuls les chunks sémantiquement très proches de la requête sont acceptés.- Personas (
code,doc,auto) : Adapte les instructions comportementales du LLM. La personacodeimpose un formatage de sortie strict pour la syntaxe de programmation, tandis quedocest optimisée pour la prose explicative. - Mode (
strictvs.hybrid) : Dicte la façon dont le LLM traite le manque de contexte. En modestrict, le modèle refusera de répondre si la réponse ne se trouve pas dans la base de données. Le modehybridpermet au modèle de s’appuyer sur ses connaissances générales en complément.
Dépannage
- Ollama inaccessible : Assurez-vous que le service Ollama est actif (
ollama serve). La gestion des modèles se fait dynamiquement pendant l’exécution. - Base de données non initialisée : Envoyer une requête sur
/queryalors que le store vectoriel est vide déclenche une erreurDatabaseEmptyError. Exécutezpython run_sync.pypour construire l’index initial.
En résumé
En combinant FastAPI, LanceDB et Ollama, vous obtenez une architecture RAG claire et hautement maintenable dans laquelle vous contrôlez chaque ligne de code—des stratégies de découpage (chunking) à la logique de streaming.
🏛️ Note finale de l’architecte : Passage à l’échelle sur le Cloud
Bien que cette configuration soit optimisée pour une exécution locale, son basculement vers un environnement hébergé sur le cloud reste simple (bien que non recommandé en raison des faibles performances en matière de concurrence des requêtes) :
- Découplage de la sauvegarde : LanceDB prend en charge nativement le stockage objet dans le cloud. Vous pouvez modifier
DB_PATHdansconfig.pypour passer d’un chemin local (./data/vector_store) à un URI AWS S3 ou MinIO (s3://my-rag-bucket/vector_store), éliminant ainsi la dépendance au disque local. - Déchargement des modèles : Au lieu d’exécuter Ollama sur le serveur d’application, pointez l’
AsyncClientdansroutes.pyvers une instance GPU dédiée ou un service d’inférence exécutant vLLM ou TGI. - Mise à l’échelle d’une API stateless : Empaquetez l’interface utilisateur dans un conteneur Docker léger (
python:3.12-slim). Étant donné que le stockage vectoriel peut résider sur S3 et l’inférence des modèles sur des nœuds GPU, votre couche API/UI devient totalement stateless et peut passer à l’échelle horizontalement derrière un reverse proxy ou un équilibreur de charge.